مشکل اصلی مدلهای زبانی در سازمانها
مدلهای زبانی بزرگ (LLM) امروز میتوانند متن بنویسند، خلاصه کنند و به سوالات پاسخ دهند؛ اما یک مشکل اساسی دارند: آنها هیچ چیزی درباره سازمان شما نمیدانند. قوانین داخلی، قیمتهای شما، فرآیندهای پشتیبانی و مستندات فنی شما جایی در آموزش این مدلها نبوده است.
راهحل قدیمی این بود که مدل را روی دادههای سازمانی «فاینتیون» کنیم؛ راهی پرهزینه، زمانبر و شکننده. اما امروز رویکرد دیگری استاندارد شده است: RAG یا Retrieval-Augmented Generation.
RAG به زبان ساده
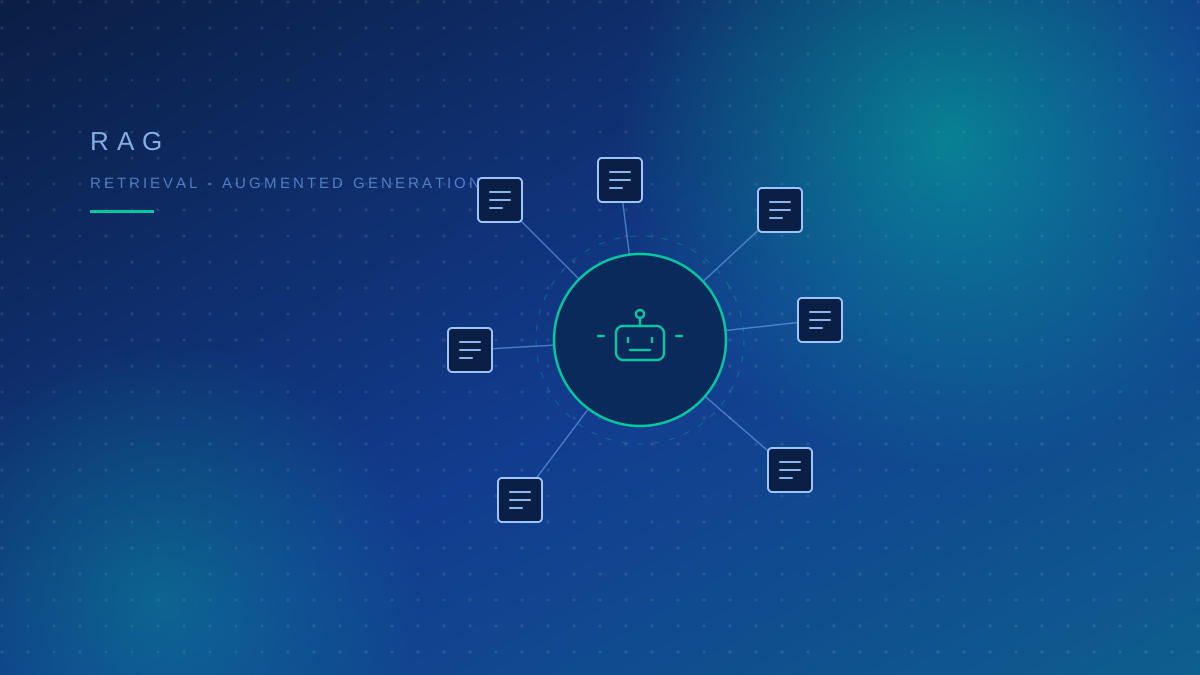
در معماری RAG، قبل از پاسخ دادن مدل، سیستم ابتدا دانستههای مرتبط با سوال را از پایگاه دانش سازمان شما (مستندات، PDFها، تیکتهای قبلی، صفحات اینترانت و…) بازیابی میکند و کنار سوال کاربر به مدل میدهد. مدل دیگر لازم نیست همهچیز را «بداند» — کافی است با مستنداتی که جلویش گذاشته شده، پاسخ بسازد.
تشبیه ساده: فرق مدل خام و مدل RAG مثل فرق یک کارشناس تازهوارد و کارشناسی است که پوشه پرونده شما را باز کرده است.
چرا RAG برای زبان فارسی حیاتیتر است؟
- دقت واژگان تخصصی: اصطلاحات فارسی حوزه شما (نام محصولات، سرویسها، واحدهای سازمانی) دقیقاً از مستندات خودتان بازیابی میشود.
- کاهش توهم (Hallucination): پاسخها به منبع واقعی متصلاند و امکان ارجاع به سند اصلی وجود دارد.
- بهروزرسانی آنی: قیمت یا قانون جدید؟ فقط سند را بهروز کنید؛ نیازی به بازآموزی مدل نیست.
- حفظ حریم داده: میتوان کل چرخه را کاملاً درونسازمانی و بدون ارسال داده به سرویسهای خارجی اجرا کرد.
اجزای اصلی یک سیستم RAG
- پردازش و تکهتکه کردن اسناد (Chunking): تبدیل مستندات به قطعات معنایی با اندازه مناسب
- مدل Embedding فارسی: تبدیل متن به بردار عددی برای جستوجوی معنایی
- پایگاه برداری (Vector DB): نگهداری و جستوجوی سریع میلیونها بردار
- فرآیند بازیابی هوشمند (Retriever): پیدا کردن مرتبطترین قطعات به هر سوال
- مدل زبانی مولد: ساخت پاسخ نهایی بر اساس قطعات بازیابیشده
جمعبندی
برای هر سازمانی که میخواهد دستیار هوشمند «خودش» را داشته باشد — از پشتیبانی مشتریان تا پاسخگویی به کارکنان — RAG نقطه شروع درست، مقرونبهصرفه و امن است. تیم هوش مصنوعی دادهپرداز در چند پروژه تولیدی، این معماری را برای زبان فارسی بهینه و مستقر کرده است.